
OMOGANEYA Technical Academy 〜 重金屋 技術塾 〜
【人工知能・機械学習|LLM | Transformer】2. 入力トークン埋め込みと位置符号
Transformerで文章を処理するためには、文章をトークンに分割したうえで、それぞれのトークンを数値で構成されたベクトルに変換する必要がある。
ただし、トークンをベクトルに変換しただけでは、そのトークンがトークン列内のどの位置にあるのかを表現できない。
そこでTransformerでは、トークンを表す入力トークン埋め込みに、トークン列内の位置を表す位置符号を加算してモデルへ入力する。
本項では、Transformerへ入力されるベクトルがどのように構成されるのか、入力トークン埋め込みと位置符号に分けて説明する。
Transformerの構成と本記事の対象
Transformerには、エンコーダのみを使用する構成、エンコーダとデコーダを組み合わせる構成、デコーダのみを使用する構成がある。
図2-1では、エンコーダに入力されるトークン列が、入力トークン埋め込みと位置符号によって入力ベクトル列へ変換され、複数のエンコーダブロックで処理される流れを示している。
エンコーダ・デコーダ構成では、入力側のトークン列がエンコーダへ入力される一方、出力側のトークン列はデコーダへ入力される。
エンコーダ側とデコーダ側の両方で、トークン埋め込みを 倍した後に位置符号を加算する。
ただし、デコーダへ入力される出力側のトークン列は、各位置において次のトークンを予測できるように、1位置ずらして入力される。
また、デコーダはエンコーダから出力された表現も受け取り、入力側のトークン列を参照しながら出力を生成する。
デコーダのみを使用する構成では、エンコーダは使用されない。
入力されたトークン列をトークン埋め込みへ変換し、位置を表す情報を加えたうえで、デコーダブロックによって次のトークンを順番に予測する。
なお、位置情報の与え方は、すべてのTransformerで同一ではない。
本項で説明する正弦関数と余弦関数による位置符号は、Transformerで使用される方法の一つである。
モデルによっては、学習によって値を更新する位置埋め込みなど、異なる方法が使用される。
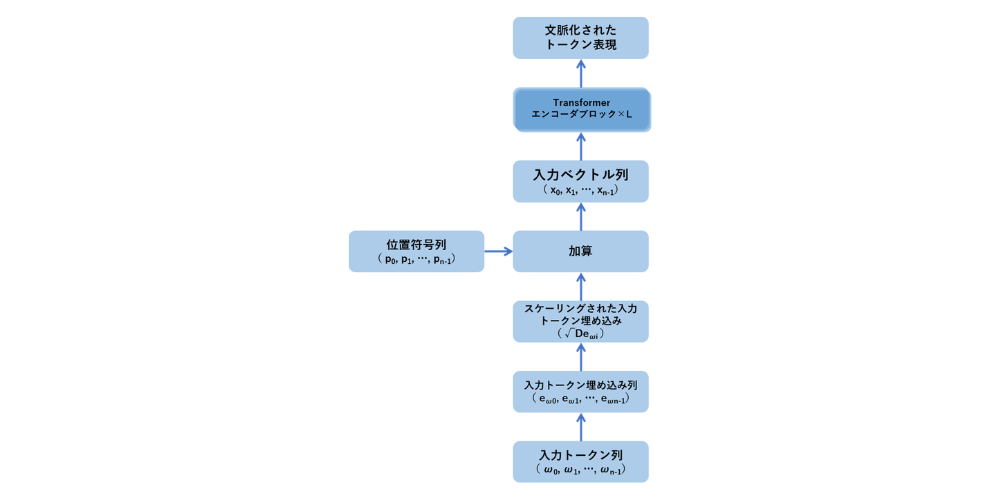
図2-1 Transformerエンコーダにおける入力トークン埋め込みと位置符号
ベクトルと次元
入力トークン埋め込みと位置符号は、いずれも複数の数値を並べたベクトルとして表される。
例えば、次のベクトルは4個の数値で構成されているため、4次元のベクトルである。
Transformerでは、このようなベクトルを使用して各トークンを表現する。
ベクトルを構成する数値の個数を、本項では と表す。したがって、 次元のベクトルには、 個の数値が含まれる。
入力トークン埋め込み
Transformerでは、語彙 に含まれる各トークンに対して、 次元の入力トークン埋め込みを用意する。
トークン に対応する入力トークン埋め込みを、次のように表す。
は、実数を要素とする 次元のベクトルであることを表している。
長さ の入力トークン列を、次のように表す。
ここで、 は、トークン列内の位置 にあるトークンを表す。
各トークンは、埋め込み層によって、それぞれに対応する 次元の入力トークン埋め込みへ変換される。
したがって、入力トークン列に対応する入力トークン埋め込みの列は、次のように表される。
入力トークン埋め込みを構成する数値を、人間がトークンごとに設定するわけではない。
Transformerでは、埋め込み層の重みもモデルの学習対象となる。
なお、この段階における入力トークン埋め込みは、トークン自体に対応するベクトルであり、トークン列内の位置を表す情報はまだ加えられていない。
入力トークン埋め込み行列
モデルが持つすべての入力トークン埋め込みは、入力トークン埋め込み行列 としてまとめて表すことができる。
ここで、 は語彙 に含まれるトークンの総数、 は各入力トークン埋め込みの次元数である。
入力トークン埋め込み行列の各行が、一つのトークンに対応する。
したがって、語彙に含まれるトークンが 個あり、それぞれを 次元のベクトルで表す場合、入力トークン埋め込み行列の大きさは となる。
位置情報が必要な理由
入力トークン埋め込み は、トークン に対応するベクトルであり、トークン列内の位置 を表すものではない。
また、Transformerは、再帰型ニューラルネットワークや畳み込みニューラルネットワークを使用せず、注意機構を中心としてトークン間の関係を処理する。
そのため、入力トークン埋め込みだけを使用した場合、トークン列内における各トークンの順序をモデルへ明示的に与えることができない。
式(2-3)で表した入力トークン列に含まれるトークンの順序を入れ替えると、元のトークン列とは異なる並びになる。
しかし、入力トークン埋め込み自体には、それぞれのトークンがトークン列内のどの位置にあるのかという情報が含まれていない。
そこで、Transformerへトークンの順序を明示的に与えるため、各入力トークン埋め込みに位置符号を加算する。
位置符号
位置符号(positional encoding)は、トークン列内における各トークンの位置を、ベクトルとして表現する方法である。
正弦関数と余弦関数を使用する位置符号では、それぞれの位置に対応するベクトルを、周期の異なる正弦関数と余弦関数を組み合わせて構成する。
正弦関数と余弦関数
正弦関数 と余弦関数 は、入力される値に応じて、一定の周期で繰り返し変化する関数である。
いずれの関数も、出力される値は (-1) から (1) までの範囲となる。
位置符号では、周期の異なる複数の正弦関数と余弦関数を組み合わせて、各位置に対応する 次元のベクトルを構成する。
位置符号の計算
トークン列内の位置 に対応する 次元の位置符号を とする。
の各要素は、次の式によって計算される。
ただし、とする。
各記号は、次の内容を表す。
:トークン列内の位置
:正弦関数と余弦関数の組を指定する整数
:位置符号および入力トークン埋め込みの次元数
位置符号では、偶数番目の要素に正弦関数を使用し、奇数番目の要素に余弦関数を使用する。
正弦関数と余弦関数を対にして使用するため、上式では を偶数としている。
位置 に対応する位置符号 は、次のように表される。
位置0の位置符号
位置 の場合、すべての正弦関数と余弦関数には0が入力される。
したがって、位置0に対応する位置符号は、次のように0と1が交互に並ぶベクトルとなる。
位置 が変化すると、それぞれの正弦関数と余弦関数の値も変化するため、各位置に対応する位置符号も変化する。
位置符号の波長
位置符号では、次元によって正弦関数および余弦関数の波長が異なる。
式(2-8)および式(2-9)で使用する正弦関数と余弦関数の波長は、 から まで等比的に増加する。
が大きい場合、最大の波長は に近づく。
したがって、一つの位置符号には、異なる波長を持つ複数の正弦関数と余弦関数の値が含まれる。
相対的な位置関係
正弦関数と余弦関数による位置符号には、一定の位置差を線形変換によって表現できる性質がある。
任意の一定の位置差 に対して、位置 の位置符号 は、位置 の位置符号 の線形関数として表すことができる。
この性質により、モデルが相対的な位置に基づいて注意を向ける方法を学習しやすくなることが期待される。
入力トークン埋め込みと位置符号の加算
入力トークン埋め込みと位置符号は、どちらも 次元のベクトルである。
そのため、入力トークン埋め込みと位置符号を、対応する要素ごとに加算することができる。
位置 にあるトークンを 、その入力トークン埋め込みを 、同じ位置に対応する位置符号を とする。
Transformerへ入力されるベクトル は、次の式で計算される。
これは、入力トークン埋め込みと位置符号のスケールをそろえるために、入力トークン埋め込みを 倍しているものと考えられる。
これをトークン列に含まれるすべての位置について計算することで、次の入力ベクトル列が得られる。
正弦関数と余弦関数による位置符号が採用された理由
Transformerでは、正弦関数と余弦関数による固定された位置符号のほか、学習によって値を更新する位置埋め込みについても比較実験が行われた。
比較実験では、固定された位置符号と学習可能な位置埋め込みは、ほぼ同等の結果を示している。
一方、正弦関数と余弦関数による位置符号には、学習時に扱った長さを超えるトークン列にも適用できる可能性がある。
この点を考慮し、固定された位置符号が採用された。
まとめ
Transformerでは、語彙に含まれる各トークンを D 次元の入力トークン埋め込みに変換する。
ただし、入力トークン埋め込みだけでは、トークン列内における位置や順序を表すことができない。
そこで、正弦関数と余弦関数によって計算した位置符号を入力トークン埋め込みに加算する。
位置 にあるトークン に対応する入力ベクトルは、次式で表される。
各位置について計算された入力ベクトルを行方向に並べることで、 次元の入力行列が構成される。
この入力行列がTransformerの各ブロックで処理され、自己注意機構などを通じて、トークン間の関係を反映した文脈化された表現へ変換されていく。
この記事について
参考文献
・「大規模言語モデル入門」山田郁夫 監修/著、鈴木正敏・山田康輔・李凌寒 著
・Ashish Vaswani et al., “Attention Is All You Need,” Advances in Neural Information Processing Systems 30, 2017.
・Alec Radford et al., “Improving Language Understanding by Generative Pre-Training,” OpenAI, 2018.
※本記事は、上記文献を参考にしつつ、筆者の理解に基づき整理したものである。
この記事を書いた企業
- 企業名
- 株式会社Lightcone Technology
- 事業内容
- LLMを活用したAIサービスの企画・開発・運営
Web・モバイルアプリケーションの企画・開発・運営
Webサイトの企画・制作
AI基盤技術の研究・開発 - URL
- https://lc-techno.com/
- 連絡先
- info@lc-techno.com
お問い合わせ
contact製品・サービスの掲載、掲載情報に関するお問い合わせ、OMOGANEYAを通じた調達・販売・取引支援について、お気軽にご相談ください。